今天中午,DeepSeek-V4.1-Flash已正式上线,能力更强,价格大幅降低
DeepSeek-V4.1-Flash已正式上线,能力更强,资费大幅降低
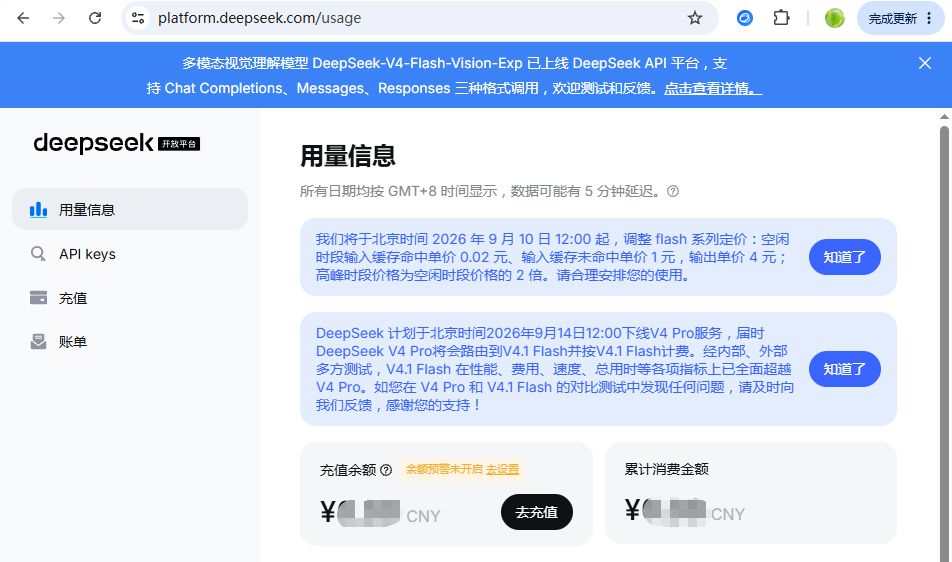
今天中午十二点,DeepSeek 的 用户大概都收到了同一条通知:V4.1 Flash 上线,价目表同步改。
紧接着第二条:9 月 14 号中午十二点,V4 Pro 下线。
降价我懂,把自家上一代旗舰直接下线,行业里真不多见。
先说价格
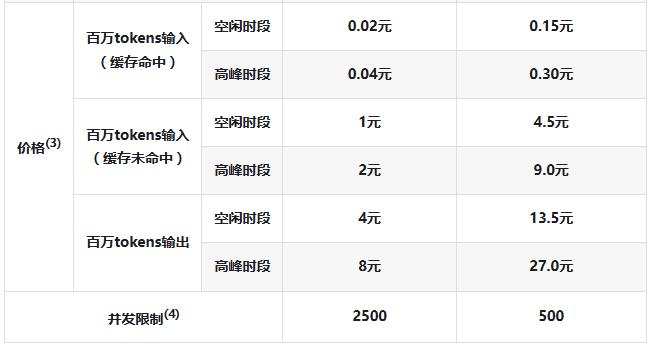
每百万 tokens:
- 输入,缓存命中:闲时 2 分,高峰 4 分
- 输入,未命中:闲时 1 块,高峰 2 块
- 输出:闲时 4 块,高峰 8 块
高峰时段:工作日 9:00–12:00、14:00–18:00,其余闲时。
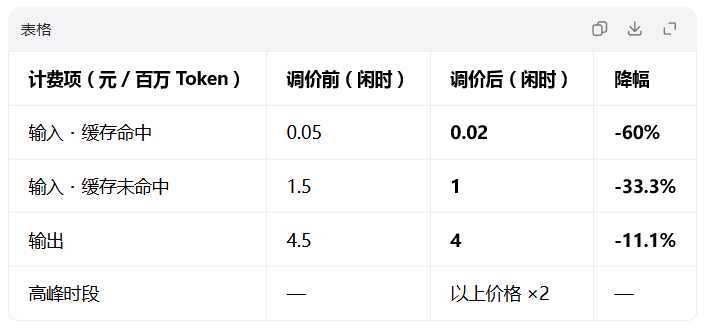
旧价:缓存命中 5 分降到 2 分,砍六成;输出 4 块 5 降到 4 块。再往前翻,高峰输出老 Flash 9 块、V4 Pro 27 块,现在 8 块。
"V4.1 Flash 在性能、费用、速度、总用时等各项指标上已全面超越 V4 Pro"是官方原话。价格随时会调,以你打开官网时看到的为准。
资费对比图(AI做的)
降在哪,比降多少更有看头
输出只降一成,缓存命中砍六成。
想撬的不是无差别让利,是调用量和缓存利用率——RAG、Agent 这类反复喂上下文的活儿最吃红利。
552B 的参数,读的时候只激活 8B
V4.1 Flash 是 552B 的 MoE,用 Causal-Encoder-Decoder,输入输出不对称:输入激活 8B,输出激活 16B。
人话就是读便宜、写贵,把读的那半边往死里省。以前编码解码共用一套预算,现在各算各的账。
KV Cache 也缩了:HBM 需求降到上一代四分之一,SSD 八分之一,加上原生支持视觉理解。Agent 场景缓存费用占比高,这一刀下去成本结构就变了。
与前代版本参数对比图:(AI给做的)
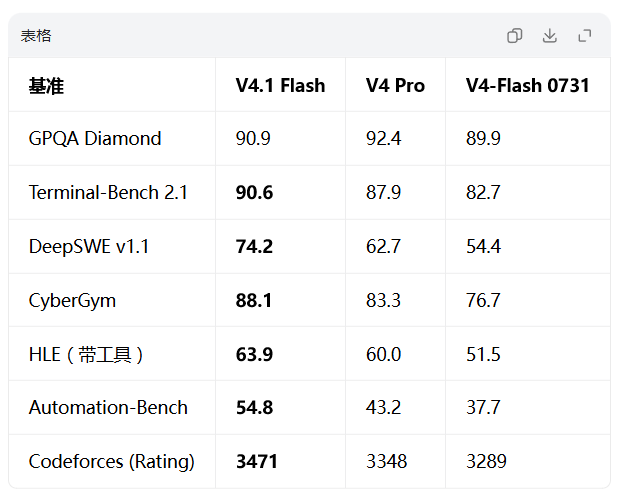
两件事,记进日历
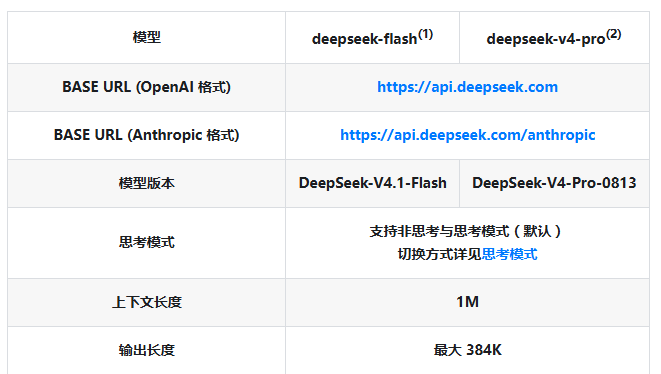
第一,9 月 14 号中午十二点 V4 Pro 下线,deepseek-v4-pro 的请求自动转到 V4.1 Flash 并按 Flash 计费。不改代码、性能变强、账单还降——但业务要是吃准了 Pro 某些行为(超长输出、特定语气、边界 case),这几天跑一遍回归。
第二,模型名改成 deepseek-flash。老的 deepseek-v4-flash 还能用,只是"暂时"路由,趁早改。
有几点要注意
速度:网传内测 284 tokens/s,官方没提,得自己实测。
时段:高峰正好盖住上班时间,晚上跑批成本省一半。
开源:权重和论文在 HuggingFace,但部署门槛是 2k 卡 GPU 加存储集群,普通人还是走 API。腾讯 WorkBuddy、CodeBuddy、已接入。
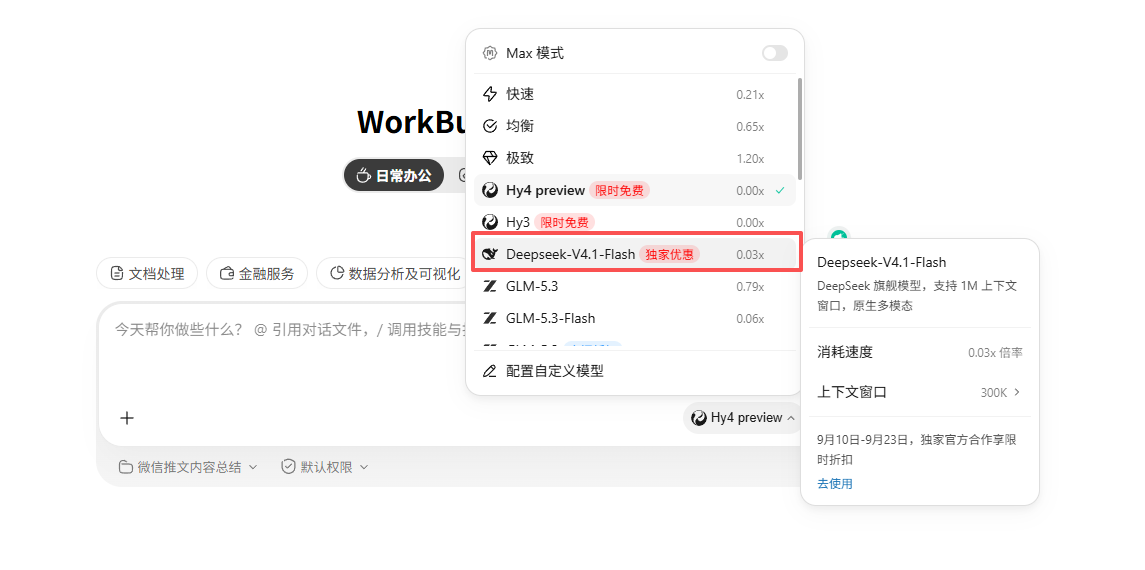
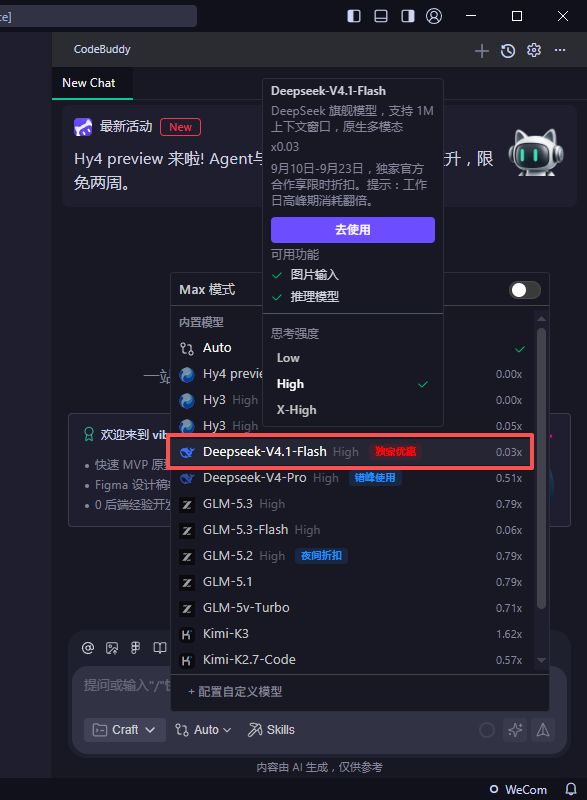
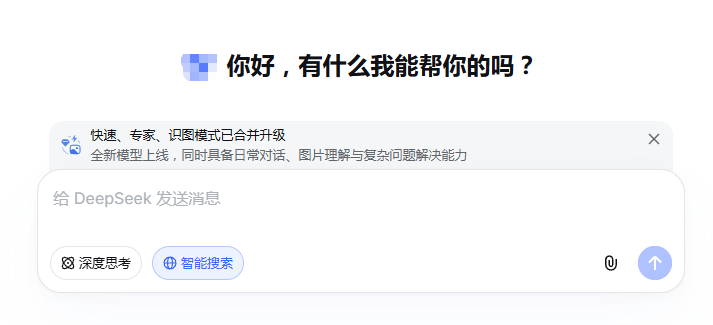
另外,deepseek官网上的网页版对话也更新了,快速、专家、识图模式已合并升级
- 分类:AI大模型
- 提供方:DeepSeek
- 浏览量:4